כאשר ChatGPT שוחרר לעולם בסוף 2022, העולם התהפך וכל מה שחשבנו שידענו על AI השתנה. האמת היא שיש מגוון של סוגי ״AI" ולכן כשאנשים שומעים שחברה כמו סמסונג כוללת AI במערכות עיבוד התמונה שלהם, הם לא מבינים את הקשר ואפילו מאמינים שזה לא AI "אמיתי".
אז מה זה בכלל AI?
זו שאלה פשוטה עם תשובה מסובכת… בגדול, AI כפי שאנחנו מכירים אותו בעת כתיבת שורות אלה, זו "מכונה" שבהנתן הרבה סוגים של מידע, מסוגלת לתת חיזוי כלשהו על בסיס המידע ההיסטורי שהיא אומנה עליו. לדוגמא, גרעין המודל של GPT הוא היכולת, בהנתן כל הידע שהוזן למודל בעת האימון שלו ובהנתן שורה של טוקנים קיימים, מסוגל לחזות ״טוקן״ אחד בלבד קדימה. זה הכל, בהנתן שורה של טוקנים, מה הטוקן שצפוי לבוא אחריהם.
טוקן הוא שבר של מילה: אות, ספרה, סימן או קומבינציה נפוצה של כאלה. ב-ChatGPT טוקן הוא לרוב שילוב של סביב 4 אותיות. המודל הוא סוג של נוסחא מתמטית שבהנתן הטוקנים שהוא קיבל (פרומפט או ״שאילתה״) יודע לחזות את הטוקן הראשון של התשובה. נריץ שוב את המודל אבל הפעם נוסיף לשרשרת הטוקנים של הפרומפט גם את הטוקן שקיבלנו בסיבוב הקודם ונקבל שוב טוקן נוסף. נריץ את זה שוב ושוב עד שנקבל טוקן שמסמן ״סיימתי״. זה נשמע מטורף, אבל זה כל הסיפור – מודל סטטיסטי שחוזה כמה אותיות קדימה על בסיס השאלה וכל חלקי התשובה שהגיעו בסיבוב הקודם, זה כל הסיפור של GPT. מה שמדהים הוא שלמרות שמדובר בסטטיטסיקה שאומנה על כמויות אדירות של מידע, הם עדיין מסוגלים להזכר ולקבל השראה מכל החומר שהם אומנו עליו.
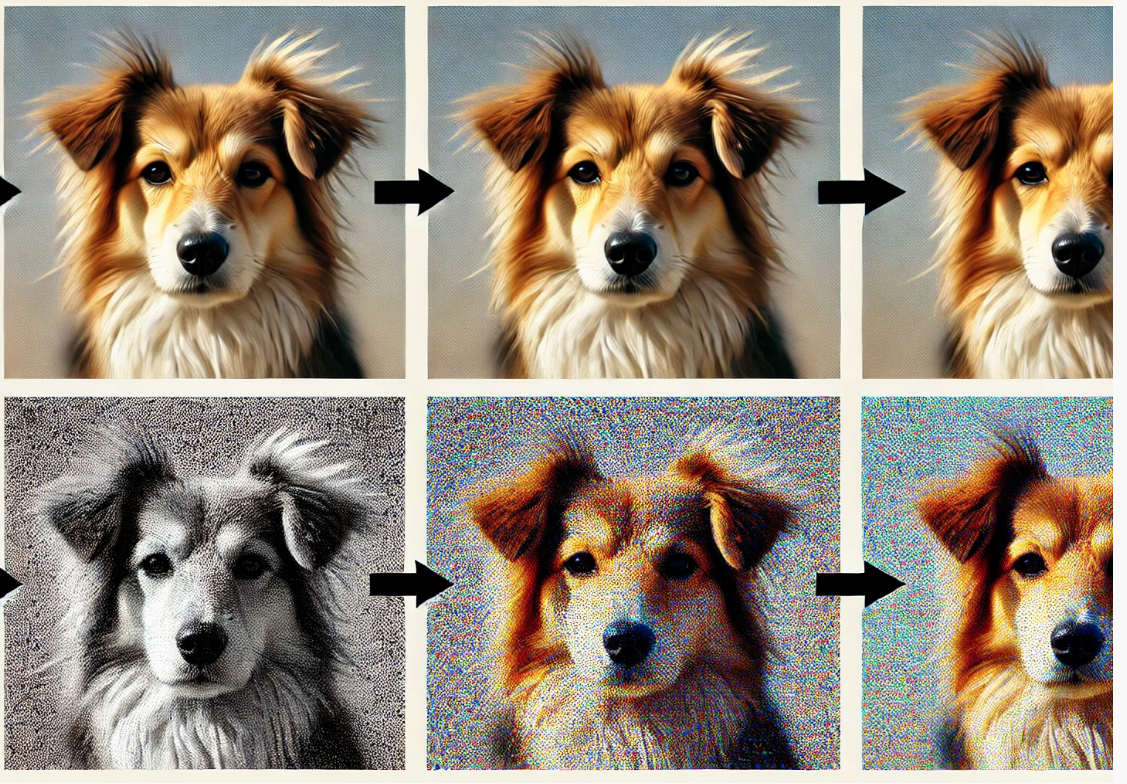
AI גנרטיבי, כזה שיודע ליצור מידע יש מאין, לא מוגבל כמובן רק ביצירת טקסט אלא שהוא כבר מסוגל לייצר גם תמונות, מוזיקה ווידאו, לחקות קול אדם ועוד. בואו וניקח לדוגמא יצירת תמונה. גרעין הרעיון של GenAI מסוגם של Dalle או מידג'רני הוא היכולת לחזות צבע של פיקסל. בהתחשב לכל שאר התמונה והפרומפט שלכם (הטקסט שביקשתם שזה יהפוך לתמונה) התוכנות האלה יתחילו מתמונה שהיא רעש לבן רנדומלי (או חתיכה מתמונה שאובייקט או מקטע מסויים הוא רעש לבן). המודלים בודקים האם כשהם משנים את הצבע של הפיקסל ומודדים את הציון של התמונה כנגד הפרומפט האם הוא נותן ציון טוב יותר או נמוך יותר. אם הצבע הרנדומלי החדש נותן ציון חזק יותר לתמונה עבור הפרומט, נשמור את הצבע אחרת ננסה צבע רנדומלי אחר. כך עושים את זה במקביל ברמת פיקסל בודד (לרוב עושים את זה על תמונה ברזולוציה נמוכה כדי לפשט את זה ואז מחדדים את זה יותר). כאן אפשר להבין שעם מעבד שיודע לעשות הרבה חישובים במקביל (GPU שיודע לעשות הרבה חישובים במקביל, או NPU שמיועד ממש להריץ מודלים) ניתן לייצר המון תמונות ולמדוד האם התמונות מתקרבות יותר לפרומפט או מתרחקות. אחרי סיבוב אחד כזה, אפשר לשוב להוסיף רעש לתמונה, כל סיבוב ברמה פחותה יותר, וכמובן רק באיזורים שאנחנו רוצים לייצר בהם את האלמנטים החדשים. כך לאט לאט, הפיקסלים בתמונה מתוקנים יותר ויותר ובהדרגה הציון שהם נותנים ביחס לפרומפט עולה ועולה… אחרי כמה עשרות סיבובים (תלוי במודל) התמונה מתחילה להתבהר והופכת דומה יותר למה שביקשנו.
התוצאות של המודלים האלה די מדהימים ביחס לעובדה שהם בסופו של דבר חוזים פרט כלשהו על בסיס מידע שהם מקבלים. ככל שהמידע שהם מקבלים שלם יותר או מחוכם יותר, וככל שהמודלים מתחזקים, כך אנחנו מתחילים לזהות ניצוצות של אינטיליגנציה.
השאלה אם זה אינטיליגנציה מלאכותית באמת, כלומר האם יש כאן ניצוץ של תובנה?

לתפיסתי, השאלה מוטעית וכנראה שכן נדע את התשובה על כך בשנים הקרובות – אם המודלים האלה באמת הדרך לתבונה או שחסר לנו עוד אלמנטים.
העניין הוא שיש סיכוי לא רע שמוחותיהם של חיות ואולי גם בני אדם, הם בעצם אוסף של ניורונים שמקבלים גירויים מסוגים שונים ועל בסיס האימון שהם עברו בשלב הלימוד שלהם, פשוט לוקחים החלטות סטטיסטיות. כלומר, יש סיכוי לא מבוטל שהמח האנושי בעצמו הוא בסופו של דבר מודל סטטיסטי שחוזה פעולות, כגון: דיבור, תנועה או מחשבה וכל זה על בסיס על כל מה שהוא למד בעבר… בקיצור, מודל גנרטיבי…
איך AI עובד עבור וידאו?
סוג הבעיות שמסכים של סמסונג צריכים לפתור הם שונים לחלוטין מאלה של GPT או Midjourney אבל העקרונות של AI דומים או אף זהים. נתחיל בדבר שכל מסך צריך לבצע: Scaling.

מסכי טלויזיה מודרנים כוללים מספר פיקסלים קבוע, לרוב 3840 טורים של 2160 פיקסלים – סה"כ למעלה מ-8 מיליון פיקסלים למסכי 4K. לסמסונג יש גם מסכי 8K ושם המספר גדל פי 4 ל-33 מיליון פיקסלים. מספר זה אינו משתנה, הוא פונקציה של החומרה של המסך. לעומת זאת, המסכים מסוגלים לקבל מספר לא קטן של רזולוציות, מ-480P, דרך רזולוציות פופולריות רבות, וכמובן רזולוציות פופולריות כגון 720P, 1080P ו-UHD (או 2160P כשמו הרשמי). למעט זה האחרון, כל שאר הרזולצויות דורשות התאמה. אם ההתאמה לא טובה, אנחנו נראה תופעות כמו מדרגות, שבירת שורות, תופעת המסרק, וטשטוש.
מזה שנים רבות מדובר באתגר לא קטן ולא מעט אלגוריתמים נכתבו במטרה לפתור את האתגר הזה. האתגר הוא פשוט לכאורה, אך מסורבל למימוש: נדרש "להמציא" או לחזות פיקסלים חדשים בהנתן התמונה שקיבלנו מבלי לעוות את המונה או לייצר טשטוש. נסיון לפתור את זה בעזרת אלגורתמיקה קלסית זו בעיה לא פשוטה – פיקסלים בגבולות של אובייקטים חייבים להיות חדים, פיקסלים באיזורים מטושטשים צריכים להשאר מטושטשים ויש לא מעט פיקסלים שהם לא שם ולא שם ומהווים את הדוגמא או הפירוט של מה שאנחנו צופים בו. השאלה היא מה עושים עם כל פיקסל ואיך מחליטים איזה טיפול הוא צריך לקבל? איך משמרים חדות בסריג ללא טשטוש בגבולות שלו ? איך משאירים פני אדם חדים ומדוייקים? איך מונעים מתמונת רקע כמו מלהפוך לרועשת או כזו שמבליטה את אלגוריתם הכיווץ וידאו שהיא עברה דרכו? איך מונעים תופעות כמו banding בגוונים דומים והדרגתיים כמו שמיים ברקע? את הבעיה הזו מנסות החברות הגדולות לפתור כ-25 שנה.
עבור סמסונג וחברות נוספות, AI היא הזדמנות חדשה לבחון את הנושא מחדש. המטרה היא בהנתן תמונה, לחזות את הערך של פיקסל אחד בדיוק בנקודה שנקבעה מראש. לשם כך, נדרש לייצר מודל מתמטי שתפקידו לחזות ערך של פיקסל בודד. איך מאמנים מודל כזה? מתחילים עם וידאו איכותי במיוחד, לדוגמא תוכן ב-8K. נדרש סוגים רבים של וידאו איכותי שכזה, שיתאים לכל הז'אנרים שעליו המודלים צפויים לפעול: ספורט, דרמות, אנימציות מצויירות, אנימציה ממוחשבת ועוד (אם כי ליגיטימי שהמודל יתנהג שונה בהנתן שהוא מזהה ז׳אנר אחר – לא בטוח שהוא יתנהג עבור אנימה באופן זהה שהוא יפעל עבור כדורגל).
את הוידאו האיכותי הזה מקטינים לרזולוציה נמוכה יותר, כגון 1080P או 720P או אפילו 480P. עכשיו מאכילים את המודל את הוידאו המוקטן ונותנים לו לנסות ולחזות את הפיקסלים של הוידאו ב-8K או ב-4K (לסמסונג יש מודל לכל אחד מהם). כמו כל מודל, אנחנו משנים את הערכים שלו בכדי לחזק אותו כשהוא משתפר ולהחליש כשהוא חוזה פחות טוב. גם כאן כנראה שהוא ינסה בהתחלה עם פיקסלים רנדומליים / רעש ודרך למידה עצמאית ועם מספיק כח חישוב, המודל יצליח לחזות וידאו חד כשהוא מקבל וידאו ברזולציה נמוכה. אם פעם הכרנו מונחים כמו Super resolution כאן מדובר על מנגנון הרבה יותר חכם וכזה שמצליח להפתיע מחדש כי הוא בזמן קצרצר (מרבית המסכים צריכים לבצע את כל העיבודים שלהם בתוך 80-100 מילישניות).
מה שמדהים הוא כמה שהמנגנון הזה מסוגל "להמציא" על בסיס מידע מאוד חלקי ומאוד עדין שהוא חשוף אליהם. כאשר אנחנו רוצים לשפר את הוידאו אנחנו גם יכולים להשתמש בפריימים קודמים (ועתידיים, על חשבון תוספת דיליי בעיבוד) בכדי למנוע יצירת ארטיפקטים ותופעות לוואי בתמונה.
כמובן שזה הסבר פשטני לרעיון, בשביל שזה יעבוד לא מספיק בשכבה אחת אלא שכבות עמוקות של ניורונים ותהליך האימון שלהם מורכב ויקר למדי, הוא דורש הרבה מאוד מעבדים חזקים מאוד (למשל H100 של חברת NVidia) בכדי לחשב את ההשפעה של כל נסיון על התוצאה.
תנועה זו בעיה קשה יותר, כאן לא נדרש להמציא פיקסל בודד ולהשלים רזולוציה, אלא שנדרש להמציא לפחות פריים שלם אחד שיושב בין פריימים קיימים. גם זו בעיה שכבר כמעט 20 שנה מנסים לפתור אותה בעזרת יוריסטיקה (אלגוריתמים מסורתיים). אמנם המנגנונים האלה משתפרים בכל שנה, אך AI מסוגל להקפיץ את האיכות של התוצאה. גם כאן, השיטה דומה, לוקחים וידאו מקור בקצב פריימים מוגבר (וידאו שצולם ב-48FPS למשל) ואז מורידים אותו לקצב פריימים נמוך יותר (24FPS למשל). עכשיו מזינים את הוידאו המשונמך למודל ומנסים להשוות את התוצאות שלו לוידאו לפני השנמוך. כאשר המודל חוזה נכון את הפיקסלים/פריימים הוא מקבל חיזוק וכשהוא לא מצליח, הוא מחליש, כך המודל משתפר בתחזית שלו.
מה עוד AI מסוגל לעשות?
בדגמי המסכים של שנת 2024 קיבלנו הצצה למגוון גדול של יכולות שמסכי סמסונג מבצעים בעזרת AI.
- זיהוי ז'אנר – מודל שמקבל קטעי וידאו שונים שתויגו לפי ז'אנר שונה מאפשר קבלת וידאו ולייצר תחזית של אחד מהז'אנרים הללו. מדוע זה חשוב? זיהוי ז'אנר מאפשר מעבר אוטומטי בין מצבים שמותאמים לז'אנר וגם התאמות לשאר המודלים. לדוגמא, זיהוי של משחק כדורגל יכול לשנות את ההגדרות לכאלה שמותאמות טוב יותר לצפיה בספורט – כולל הפעלת מנגנוני צבע (שישפרו את חדות וצבע הדשא), עיבוד תנועה (של הכדור והשחקנים) ושאר הגדרות תמונה שנכונים יותר לז'אנר הזה.
- זיהוי ושדרוג קונטרסט – גם כאן, המודל מזהה מקומות שבהם ניתן לשדרג את הקונטרסט ואת עוצמת האור ולמתוח אותם כל עוד זה אינו פוגע באיכות התמונה ומייצר ארטיפקטים או הפרעות.
- שדרוג אובייקטים קדימה ורקע Real Depth enhancer – מנגנון זה חמקמק במיוחד ותפקידו לזהות אובייקטים שהם בקדמת המסך והפוקוס צריך להיות עליהם. אותם המנגנון מחדד בעוד שאזורים שהוא מסווג כרקע ושאותם ניתן לטשטש (במידה מוגבלת כמובן). לשם כך נדרש זיהוי גם של אובייקטים וגם של המושג "רקע", וזה נעשה על ידי תיוג וזיהוי וכן עיבוד שמקבל את התוצרים של הזיהוי ומבצע את העיבוד המתאים. התוצאה שלו אפקט תלת מימדי דומה לבוקה (Bokeh) בצילום.
- הפרעות של רעש רקע – המסך של סמסונג מריץ מודל מקומי שבהנתן רעש רקע מסוגל לזהות את סוגו ועוצמתו ולחזות, בהנתן בסאונד שהטלויזיה כרגע מנגנת, באיזו מידה הרעש הזה מפריע לצופה ולהגביר ולשנות את עוצמת האודיו בהתאם.
- זיהוי אובייקטי אודיו ושדרוג OTS+ אטמוס – כאן המשימה מורכבת – נדרש לפרק את האודיו שאנחנו מקבלים (נניח בסטריאו למשל) בכדי להפוך את הסאונד לרב ערוצי. כך המודל צפוי לחזות שצליל של מטוס צריך להגיע מהרמקולים העליים, בעוד שקול אדם צריך להגיע מהאיזור שבו אותה הדמות נמצאת על המסך. זה מודל מורכב שיכול לקבל וידאו וסאונד ממספר ערוצים קטן ולחזות את הסאונד של כל הרמקולים של המסך – ובכך לייצר סאונד אותנתי אך כזה שיופק בשילוב רמקולים שישקף את מה שקורה במסך.
כל האלגוריתמים הללו מצטרפים למודלים שכבר הכרנו בעבר כמו זיהוי קול, שדרוג עוצמות הווליום בכדי להפוך אותם אחידים בין מקורות שונים ועוד.
אז איך זה מבוצע בפועל?
מה משותף בכל המודלים הללו? כולם בסופו של דבר מקבלים כמות גדולה של מספרים שמשקפים את מה שקורה באודיו או וידאו ותוצרים שלהם הם הוידאו או האודיו שאנחנו שומעים בפועל. עיקר העבודה נעשית מאחורי הקלעים – סמסונג מאמנת מודלים על בסיס כמות גדולה של קטעי וידאו ומשתמשת במעבדי על בכדי לאמן את המודלים האלה. הדרישה מהמעבד שבמסך צנועה בהרבה – הוא משתמש במודלים השונים שרצים במקביל לפי הצורך, ותפקידם להריץ את המודלים שאומנו קודם לכך.
במסכי 4K המעבד הכי מתקדם של סמסונג, לפחות בעת כתיבת שורות אלה, הוא מעבד ה- NQ4 AI Gen2, בעוד שלמסכי 8K נדרש מעבד חזק יותר: NQ8 AI Gen3.
ב-4K נדרש שידרוג של המעבד פי 4 במהירות העיבוד שלו, כאשר מספר הרשתות ניורליות שהמעבד מסוגל להפעיל גדל פי 2.5 (עם 20 רשתות פעילות בכל זמן נתון לכל הפחות).
ב-8K, השדרוג דרמטי אפילו יותר, עם מעבד פי 2 מהיר יותר מהדור הקודם ועם 512 רשתות עצביות, כלומר פי 25! נוסף על כך גם מעבד GPU חזק פי 2.2 ומעבד חזק ב-30% מהדור הקודם שמפעילים גם רשתות עבור תאורת רקע ועוד דברים ספציפיים ל-miniLED.
לסיכום, מי שלא חושב שמדובר ב-AI כנראה לא מבין כיצד AI מוגדר או איך הוא עובד. נקווה שאחרי שיקראו את המאמר יפנימו טוב יותר את המהפכה שמכניס ה-AI לחיינו באין סוף דרכים שונות ומשונות.
כל התמונות במאמר נוצרו על ידי AI


